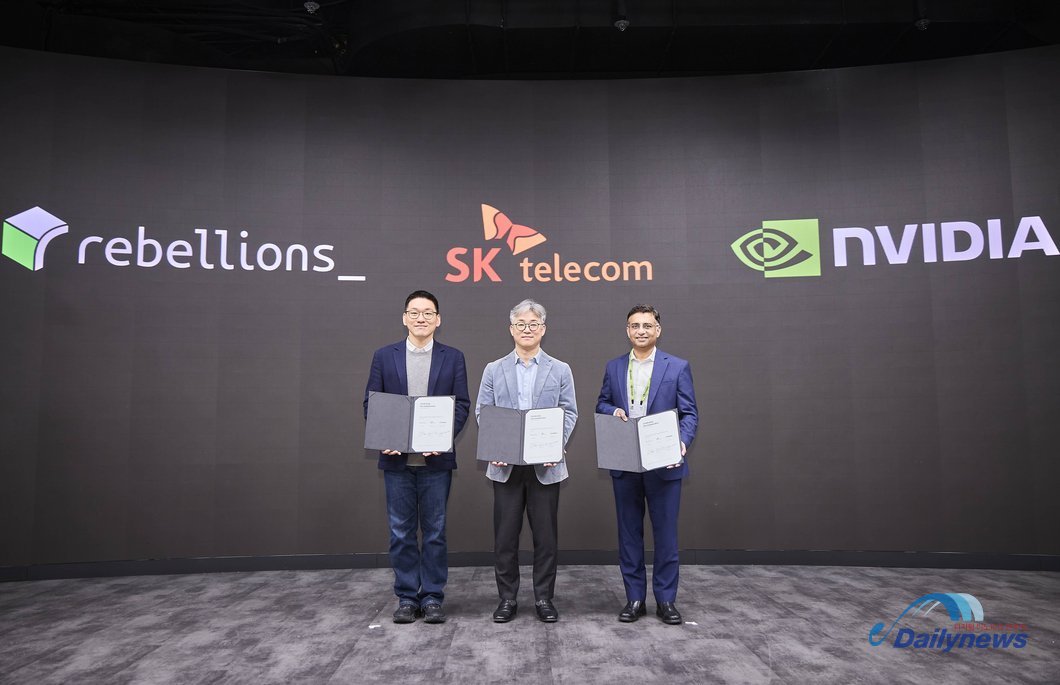
SK텔레콤과 엔비디아, 국내 인공지능(AI) 반도체 기업 리벨리온이 생성형 AI의 입력 처리와 답변 생성을 서로 다른 반도체에 맡기는 서버 시스템을 개발한다. 3사는 9일 서울 코엑스에서 열린 ‘엔비디아 AI 데이 서울’에서 그래픽처리장치(GPU)와 신경망처리장치(NPU)를 통합한 시스템을 개발하고 검증하기 위한 업무협약을 체결했다. 엔비디아 GPU가 사용자 입력을 먼저 처리하고, 리벨리온이 개발 중인 NPU ‘레벨 R200’이 그 결과를 받아 답변을 만드는 방식이다.
두 종류의 반도체를 연결하는 데에는 엔비디아의 ‘NVLink Fusion’이 쓰인다. 엔비디아의 고속 연결 기술을 다른 기업이 설계한 AI 반도체에도 적용할 수 있도록 확장한 기술이다. 3사는 여기에 엔비디아의 서버 설계 규격인 ‘MGX’를 적용해 랙 단위의 시스템을 개발할 계획이다. 랙은 데이터센터에서 여러 서버와 관련 장비를 장착하는 틀을 말한다. 이번 협력에서는 개별 칩의 성능과 함께 여러 장치가 한 시스템 안에서 데이터를 주고받으며 추론 요청을 처리할 수 있는지가 중요하다.
생성형 AI가 답변을 만드는 과정은 크게 프리필과 디코드로 나뉜다. 프리필은 사용자가 입력한 질문과 앞선 대화 등의 내용을 모델이 읽어들이고, 답변을 생성하는 데 필요한 정보를 준비하는 단계다. 한 번에 처리할 입력이 길어질수록 계산할 분량도 늘어난다. 디코드 단계에서는 모델이 문장에 이어질 토큰을 하나씩 선택한다. 토큰은 모델이 텍스트를 다루는 단위로, 한 단어가 여러 토큰으로 나뉠 수도 있다. 답변이 길면 이 과정이 반복되기 때문에 메모리에서 필요한 데이터를 얼마나 빠르게 불러올 수 있는지가 처리 속도에 영향을 준다.
3사는 계산량이 많은 프리필을 GPU에, 토큰을 순차적으로 만들어내는 디코드를 NPU에 배정한다. 가령 사용자가 긴 보고서를 첨부하고 요약을 요청하면 GPU가 보고서와 지시문을 먼저 처리하고, NPU가 그 결과를 바탕으로 요약문을 생성하는 식이다. 입력이 길고 답변은 짧은 요청과, 입력은 짧지만 답변이 긴 요청은 두 단계에 필요한 자원이 서로 다르다. 단계를 나눠 운영하면 이런 요청이 섞여 들어올 때 각 처리 단계에 필요한 장비를 따로 배분할 수 있다.
처리를 나누는 만큼 GPU에서 계산한 중간 정보를 NPU로 넘기는 과정이 추가된다. 이전에 처리한 입력과 생성 중인 문장의 정보를 답변이 끝날 때까지 활용해야 하므로 장치 간 전송 시간과 메모리 사용량도 전체 성능에 영향을 준다. 요청이 몰리는 시간대에 한쪽 장비가 먼저 포화되면 다른 쪽에 여유가 있어도 답변 시작이 늦어질 수 있다. 통합 시스템의 효과를 평가할 때는 첫 토큰이 표시되기까지 걸린 시간과 이후 답변이 생성되는 속도, 동시에 처리한 요청 수를 구분해 볼 필요가 있다. 각각 사용자의 대기 시간과 답변을 읽는 체감 속도, 서버의 처리 용량을 보여주는 지표다.
SK텔레콤은 통합 시스템을 자사 AI 데이터센터에 도입해 성능과 안정성을 실증하고, 서비스 적용과 상용화 가능성을 검토할 계획이다. 자체 AI 모델과 정부의 ‘모두의 AI’ 프로젝트를 포함한 대국민 서비스에 시스템을 활용하는 구상도 제시했다. 엔비디아가 서버 설계와 반도체 연결 기술을, 리벨리온이 국내에서 설계한 AI 반도체를, SK텔레콤이 데이터센터 운영 환경과 모델·서비스 역량을 제공하는 구조다. 과학기술정보통신부는 국내 AI 반도체와 AI 인프라를 연결하는 이번 협력을 지원한다.
상용화 검토에서는 모델이 달라져도 같은 방식으로 구동할 수 있는지, 이용자가 몰릴 때 안정적으로 응답하는지 등 운영 조건이 중요하다. 데이터센터의 전력 효율도 칩 한 개의 소비전력과 서비스 전체의 소비전력을 나눠 살펴야 한다. 같은 모델과 요청을 처리할 때 서버 한 대가 사용하는 전력이 줄더라도, 목표 응답 속도를 맞추기 위해 서버를 더 많이 가동하면 전체 전력 사용량은 달라질 수 있다. 반대로 동일한 장비에서 더 많은 요청을 소화할 경우에는 일정한 전력으로 제공할 수 있는 서비스 용량이 커진다.
이번 협약에서 3사가 공개한 내용은 개발 방식과 데이터센터 실증 계획이다. 공개 자료에는 실증 착수일과 투입 장비 규모, 기존 구성과 비교한 처리량·소비전력 수치가 담기지 않았다. 리벨리온의 R200이 실제 서비스 환경에서 GPU와 함께 동작할 때 어느 정도의 응답 속도를 내는지, 요청의 길이와 동시 접속 규모에 따라 성능이 어떻게 달라지는지는 실증 결과를 통해 확인할 수 있다. 실증을 거쳐 상용 서비스에 적용할 모델과 운영 규모가 정해질 전망이다.


댓글
0