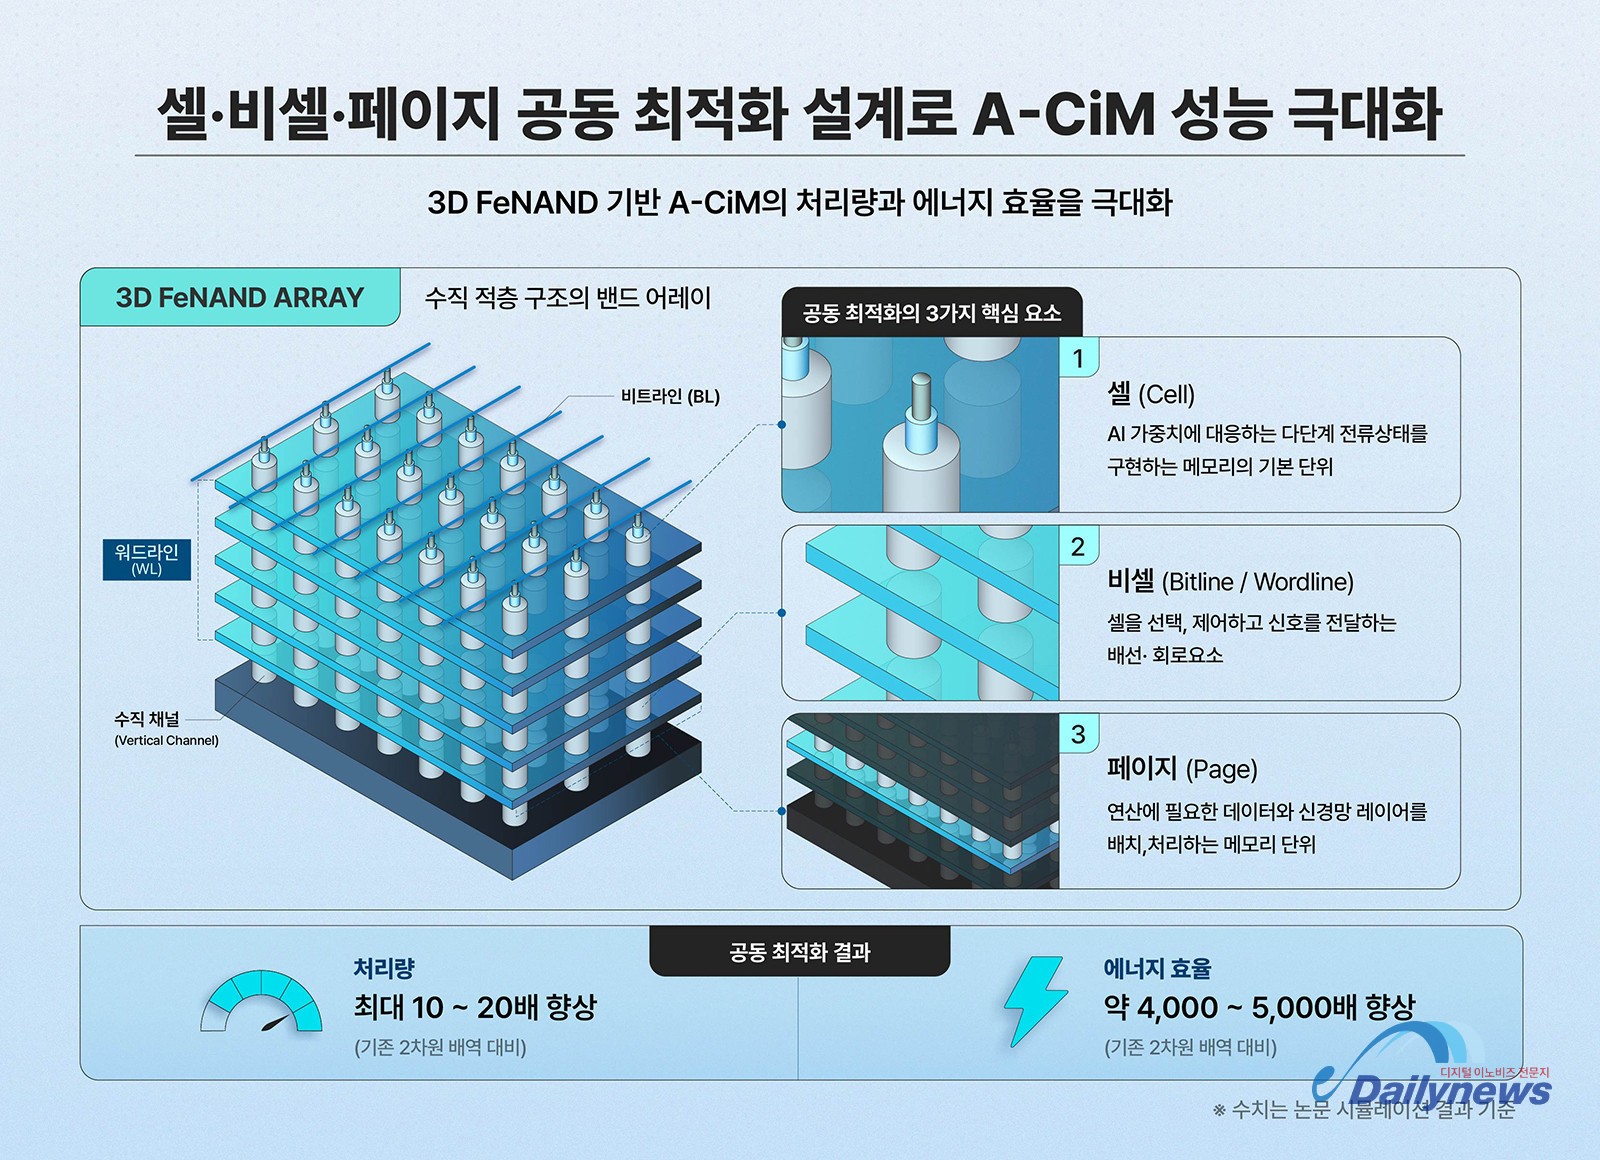
SK하이닉스 연구팀이 강유전체를 적용한 3D FeNAND를 기반으로 메모리 셀과 비셀 구조, 페이지 운용 방식을 함께 최적화해 AI 연산의 처리량과 에너지 효율을 높이는 설계를 제시했다. 시뮬레이션에서는 제한된 칩 크기 조건에서 기존 2차원 비휘발성 메모리 배열과 비교해 처리량이 약 10~20배, 에너지 효율이 약 4,000~5,000배 향상됐다.
이번 연구는 메모리 안에서 아날로그 방식으로 연산하는 A-CiM에 3D FeNAND를 적용하고, 소자부터 배선과 데이터 배치까지 하나의 시스템으로 조정한 것이 핵심이다. 높은 집적도를 활용해 AI 모델의 가중치를 더 많이 저장하면서, 데이터를 반복해서 옮기거나 다시 기록하는 부담을 줄이는 데 초점을 맞췄다.
데이터 이동 줄이는 메모리 내부 연산에 주목
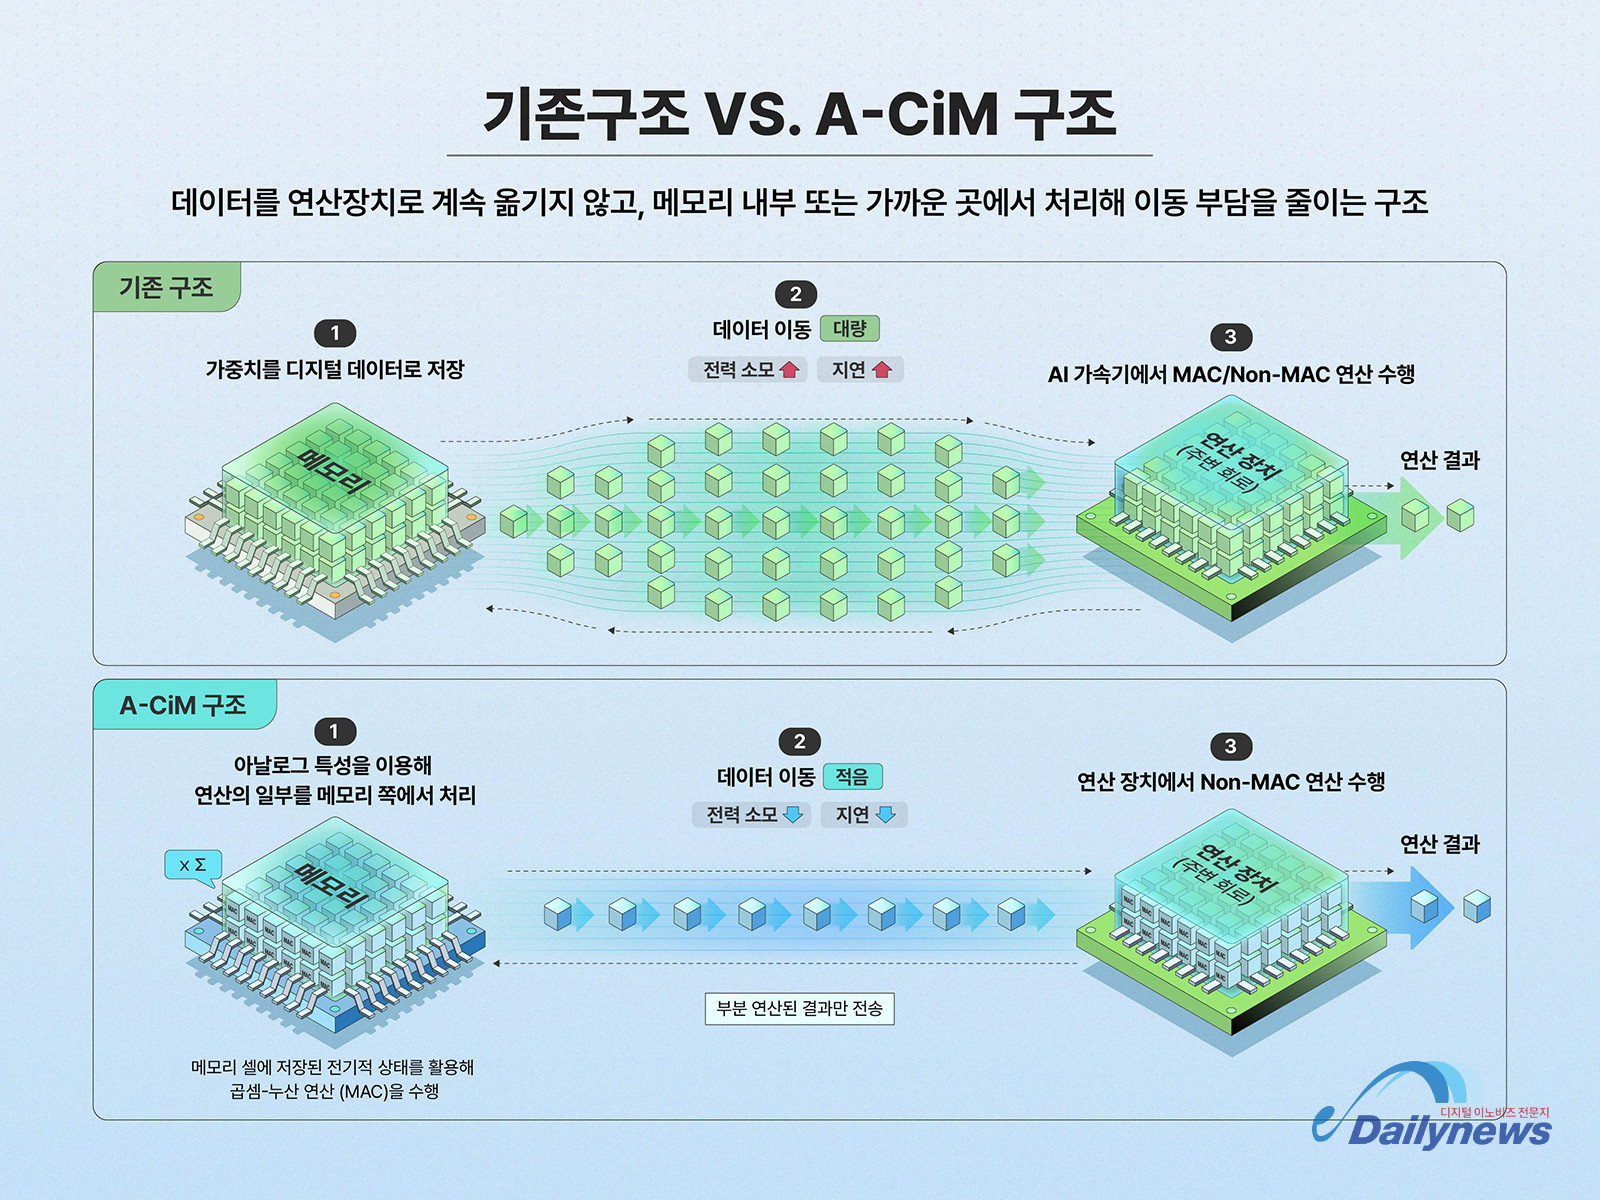
AI 모델이 커지면서 데이터를 저장 장치와 연산 장치 사이에서 이동시키는 데 드는 전력과 시간이 주요 병목으로 떠오르고 있다. 연산 장치 자체의 속도뿐 아니라 데이터를 어디에 저장하고 처리하는지도 전체 시스템의 효율에 영향을 주는 것이다.
컴퓨팅 인 메모리(CiM)는 데이터를 연산 장치로 계속 옮기는 대신 메모리 내부나 가까운 곳에서 처리해 이동 부담을 낮추는 기술이다. 이 가운데 A-CiM은 메모리 셀에 저장된 전기적 상태를 이용해 AI 연산의 기본인 곱셈-누산(MAC)을 수행한다. MAC은 곱셈과 덧셈을 반복하는 연산으로, AI 모델의 학습과 추론에 쓰인다.
대규모 AI 모델을 처리하려면 많은 가중치 데이터를 저장하고 반복해서 읽어야 한다. 이에 따라 높은 저장 밀도와 정밀한 전류 제어를 함께 갖춘 메모리 구조가 중요해졌다.
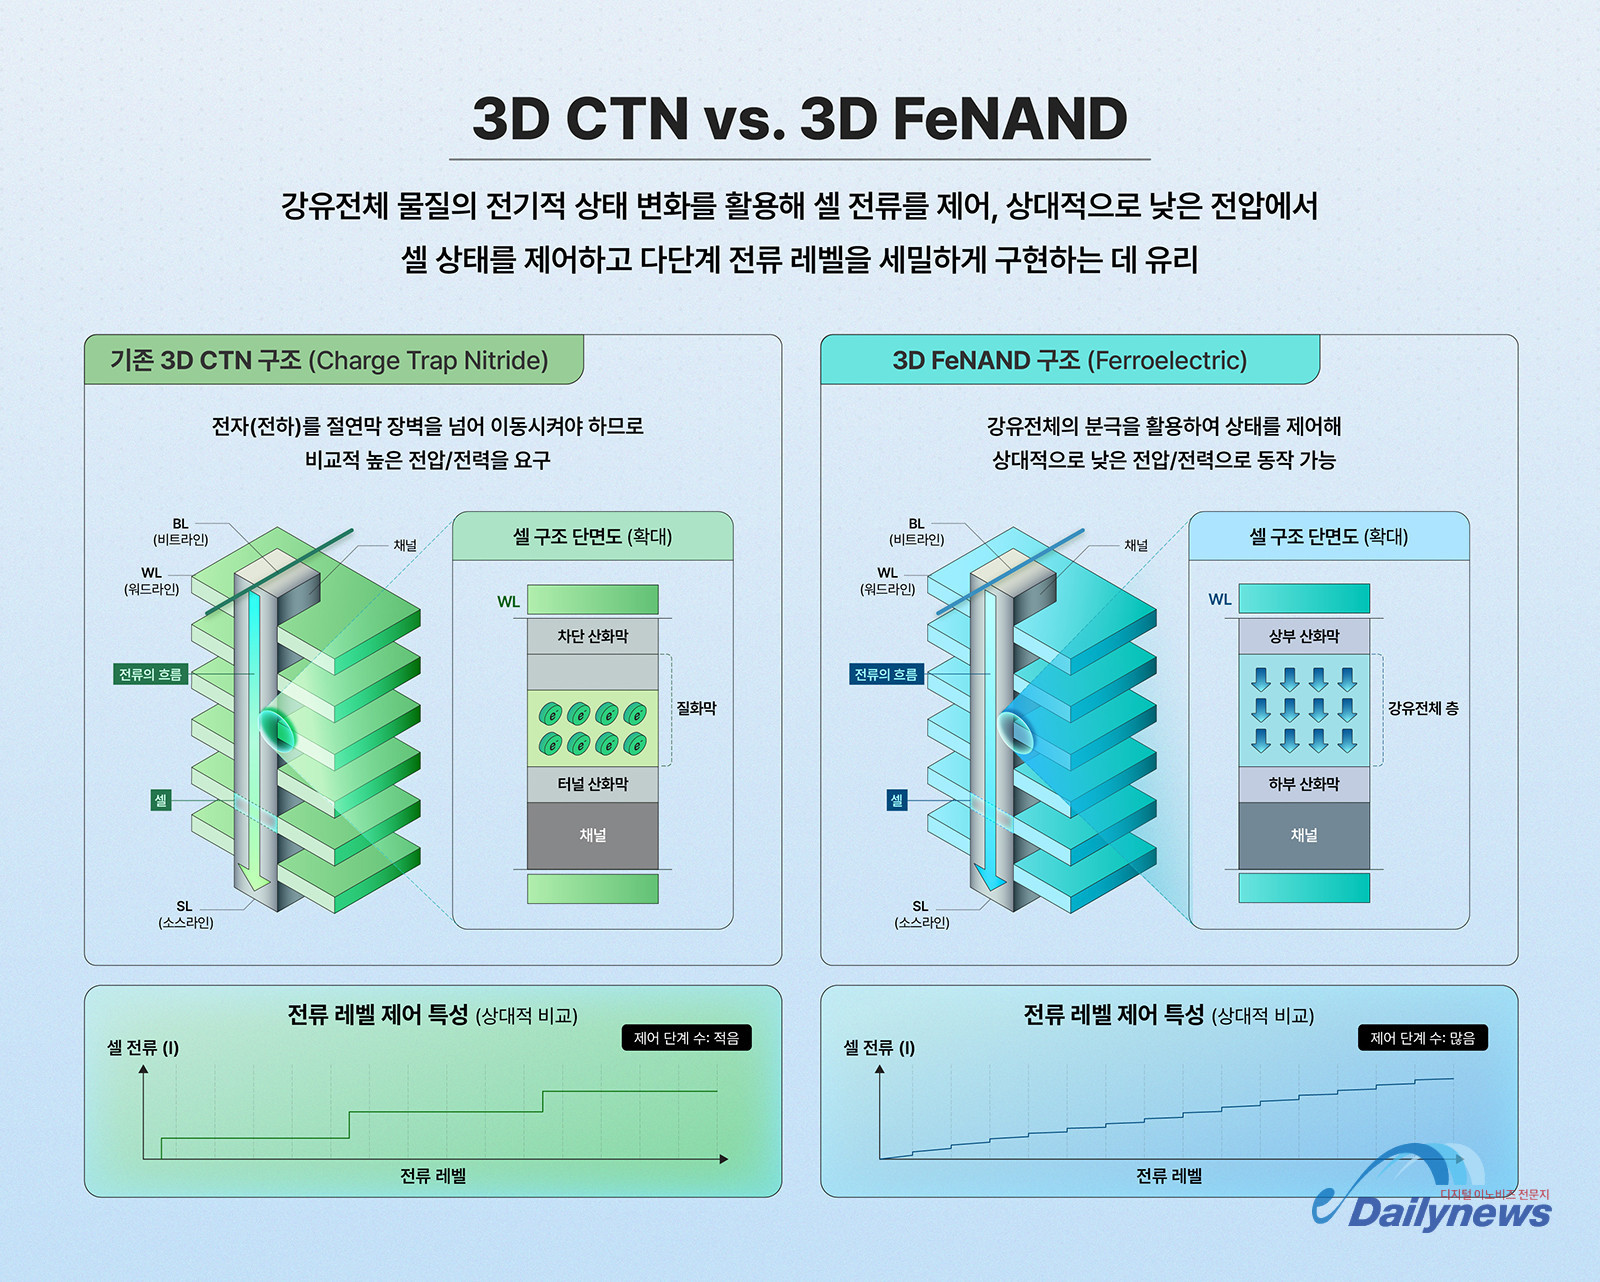
현재 상용 3D 낸드에 주로 사용되는 CTN 구조는 질화막에 전자를 가두거나 빼내 셀 상태를 바꾼다. 집적도에는 강점이 있지만, 아날로그 연산에 필요한 여러 전류 레벨을 세밀하게 구분하는 데에는 한계가 있다.
반면 3D FeNAND는 외부 전기장이 사라진 뒤에도 분극 상태를 유지하는 강유전체의 특성을 활용한다. 분극 상태를 바꿔 데이터를 저장하고 셀 전류를 조절하기 때문에 기존 3D CTN 낸드보다 낮은 전력으로 다단계 전류 상태를 제어하는 데 유리하다.
다만 셀의 특성만 개선해서는 전체 연산 효율을 충분히 높이기 어렵다. 셀을 선택하는 배선에서 전력 손실이 발생하거나, 연산 데이터가 비효율적으로 배치돼 페이지 전환이 늘어나면 성능이 제한된다. 연구팀은 이를 해결하기 위해 셀, 비셀, 페이지를 함께 조정하는 공동 최적화 방식을 적용했다.
셀 최적화로 다단계 전류 상태 정밀하게 구현
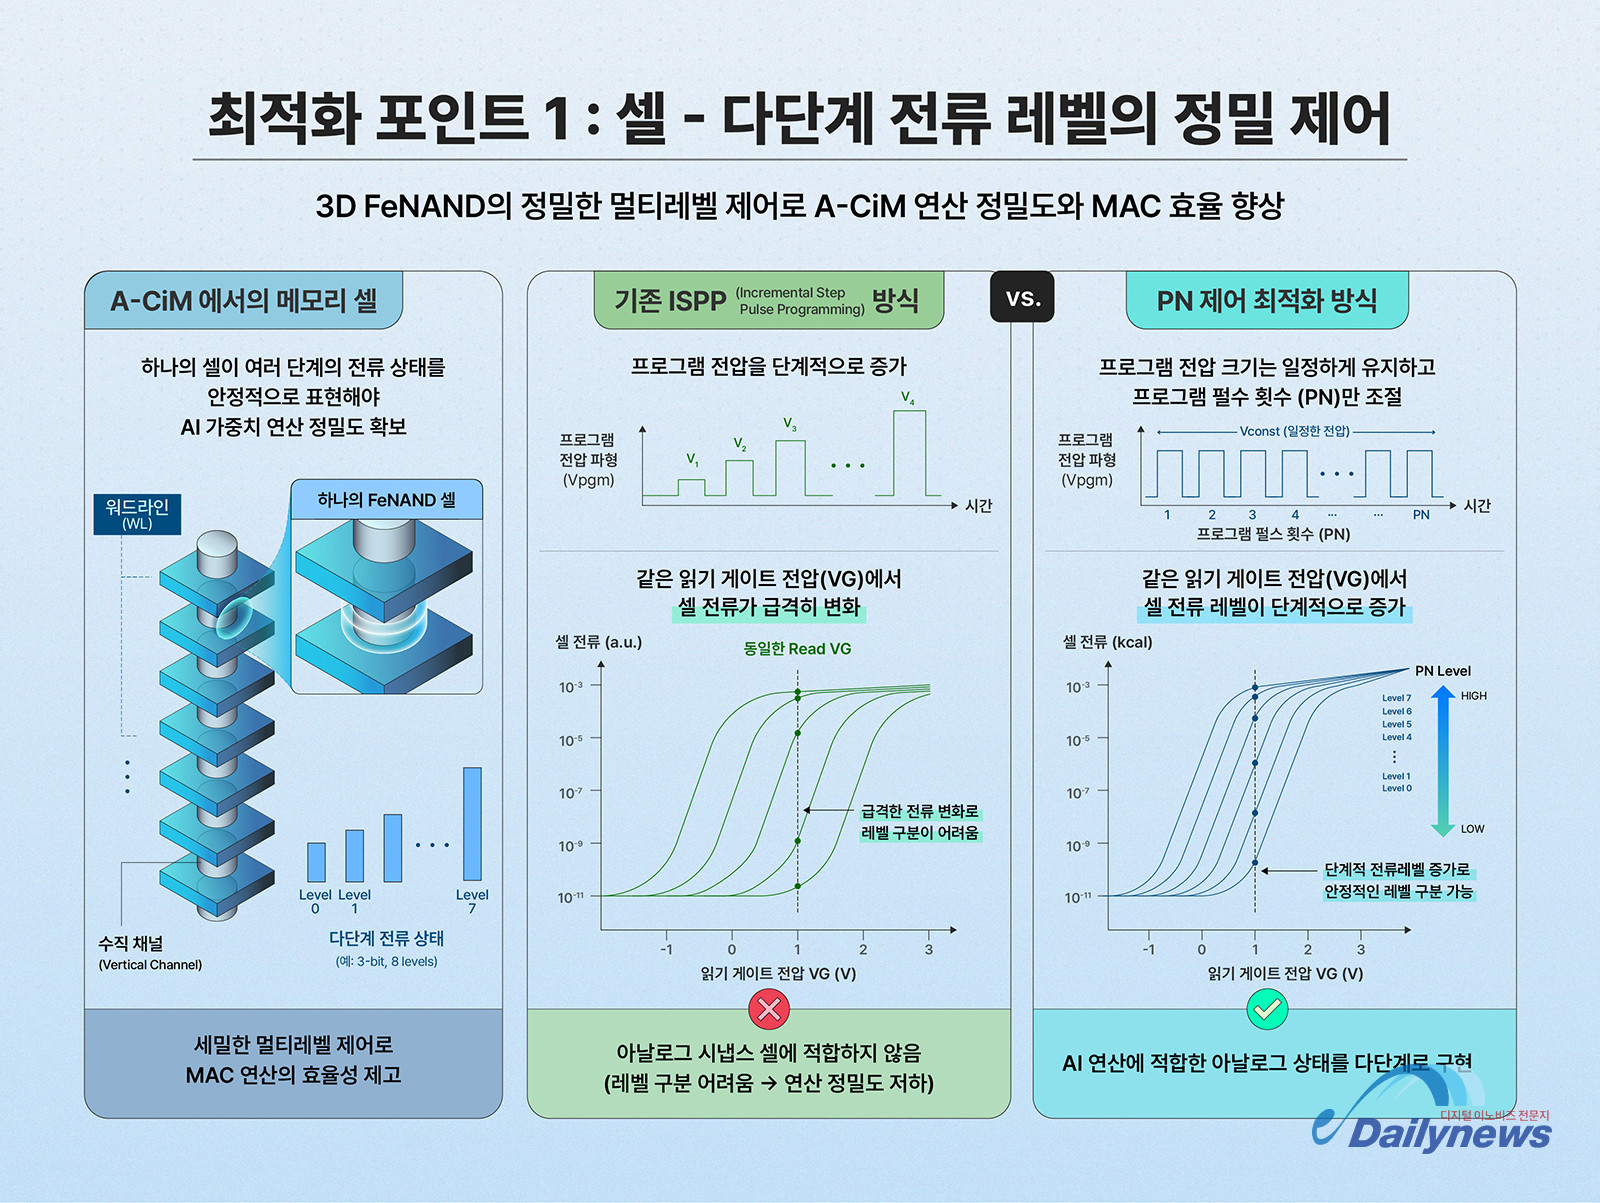
셀 영역에서는 AI 가중치를 여러 단계의 전류 상태로 안정적으로 표현하는 데 집중했다. A-CiM의 셀은 단순히 0과 1을 저장하는 것을 넘어 다양한 전기적 상태를 구분해야 한다. 이러한 멀티레벨 특성이 충분하지 않으면 아날로그 연산의 정밀도와 MAC 연산 효율이 떨어질 수 있다.
기존 낸드는 프로그램 전압을 단계적으로 높이는 ISPP 방식으로 문턱전압을 조절한다. 문턱전압은 셀에 전류가 흐르기 시작하는 기준 전압이다. 그러나 이 방식에서는 같은 읽기 게이트 전압에서도 셀 전류가 급격하게 달라질 수 있어, 여러 전류 상태를 점진적으로 구분해야 하는 아날로그 연산에 제약이 있다.
연구팀은 3D FeNAND에서 동일한 전압으로 가하는 프로그램 펄스의 횟수를 늘리고, 이후 전압을 단계적으로 높이는 과정은 최소화했다. 펄스 횟수가 증가할수록 문턱전압은 점차 포화됐고, 같은 읽기 게이트 전압에서 측정한 전류 레벨은 단계적으로 높아졌다. 이를 통해 AI 연산에 필요한 아날로그 상태를 여러 단계로 구분하도록 했다.
셀 상태 제어에는 하프늄·지르코늄 산화물 기반의 HZO 강유전체 물질이 활용됐다. 강유전체 내부의 분극 방향이 바뀌는 도메인 스위칭을 이용해 저전류 영역에서도 정밀한 멀티레벨 동작을 구현했다. 300mm 웨이퍼 규모에서는 셀당 4레벨 동작과 안정적인 데이터 보존 특성이 확인됐다.
워드라인 저항과 커패시턴스 낮춰 전환 부담 완화
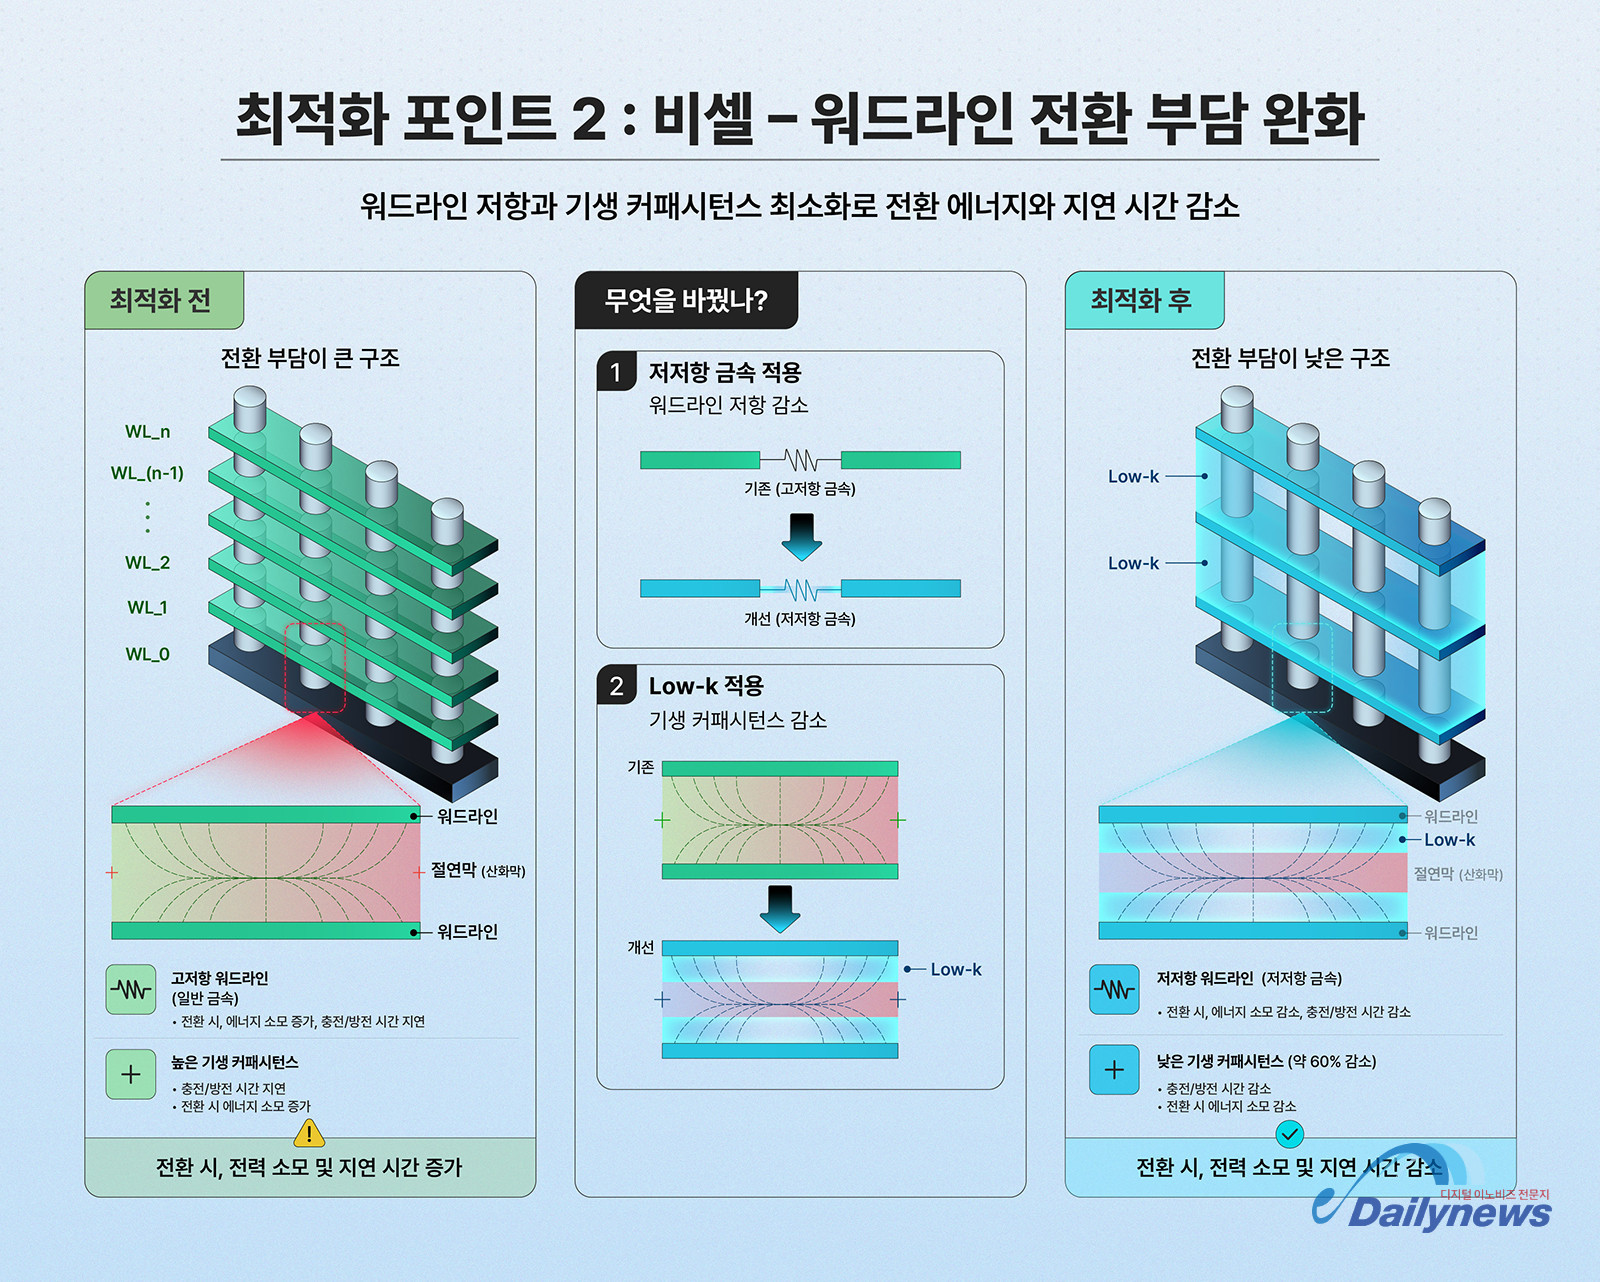
비셀 영역에서는 셀을 선택하고 제어하는 워드라인의 전력 소모와 지연을 줄였다. A-CiM은 MAC 연산 과정에서 선택 워드라인과 비선택 워드라인을 반복적으로 전환한다. 이때 배선의 저항과 커패시턴스가 크면 신호 전달이 늦어지고 전환에 필요한 에너지도 늘어난다.
연구팀이 저저항 금속을 워드라인에 적용한 결과, 기준 구조보다 처리량은 최대 16%, 에너지 효율은 최대 3% 개선됐다. 에너지 효율의 개선 폭이 상대적으로 작았던 것은 전체 전력 소모가 워드라인 저항보다 커패시턴스의 영향을 더 크게 받았기 때문이다.
워드라인 사이의 산화막에 공기층을 만드는 에어갭 구조를 적용하면 기생 커패시턴스를 약 60% 낮출 수 있었다. 기생 커패시턴스는 가까운 배선 사이에서 의도하지 않게 생기는 전기적 용량 성분으로, 신호 지연과 전력 소모를 키울 수 있다.
에어갭 적용에 따른 처리량은 1.2배, 에너지 효율은 2배 향상됐다. 워드라인 저항과 커패시턴스를 함께 최적화했을 때는 처리량이 최대 1.4배, 에너지 효율이 최대 2.2배 높아졌다.
이러한 비셀 최적화는 셀에 저장된 정밀한 전류 상태를 실제 연산에 활용하는 과정의 부담을 낮추는 역할을 한다. 셀 성능이 좋아도 이를 선택하고 전환하는 데 많은 전력과 시간이 필요하면 메모리 내부 연산의 이점이 줄어들기 때문이다.
페이지 안의 연산 순서와 데이터 배치 조정
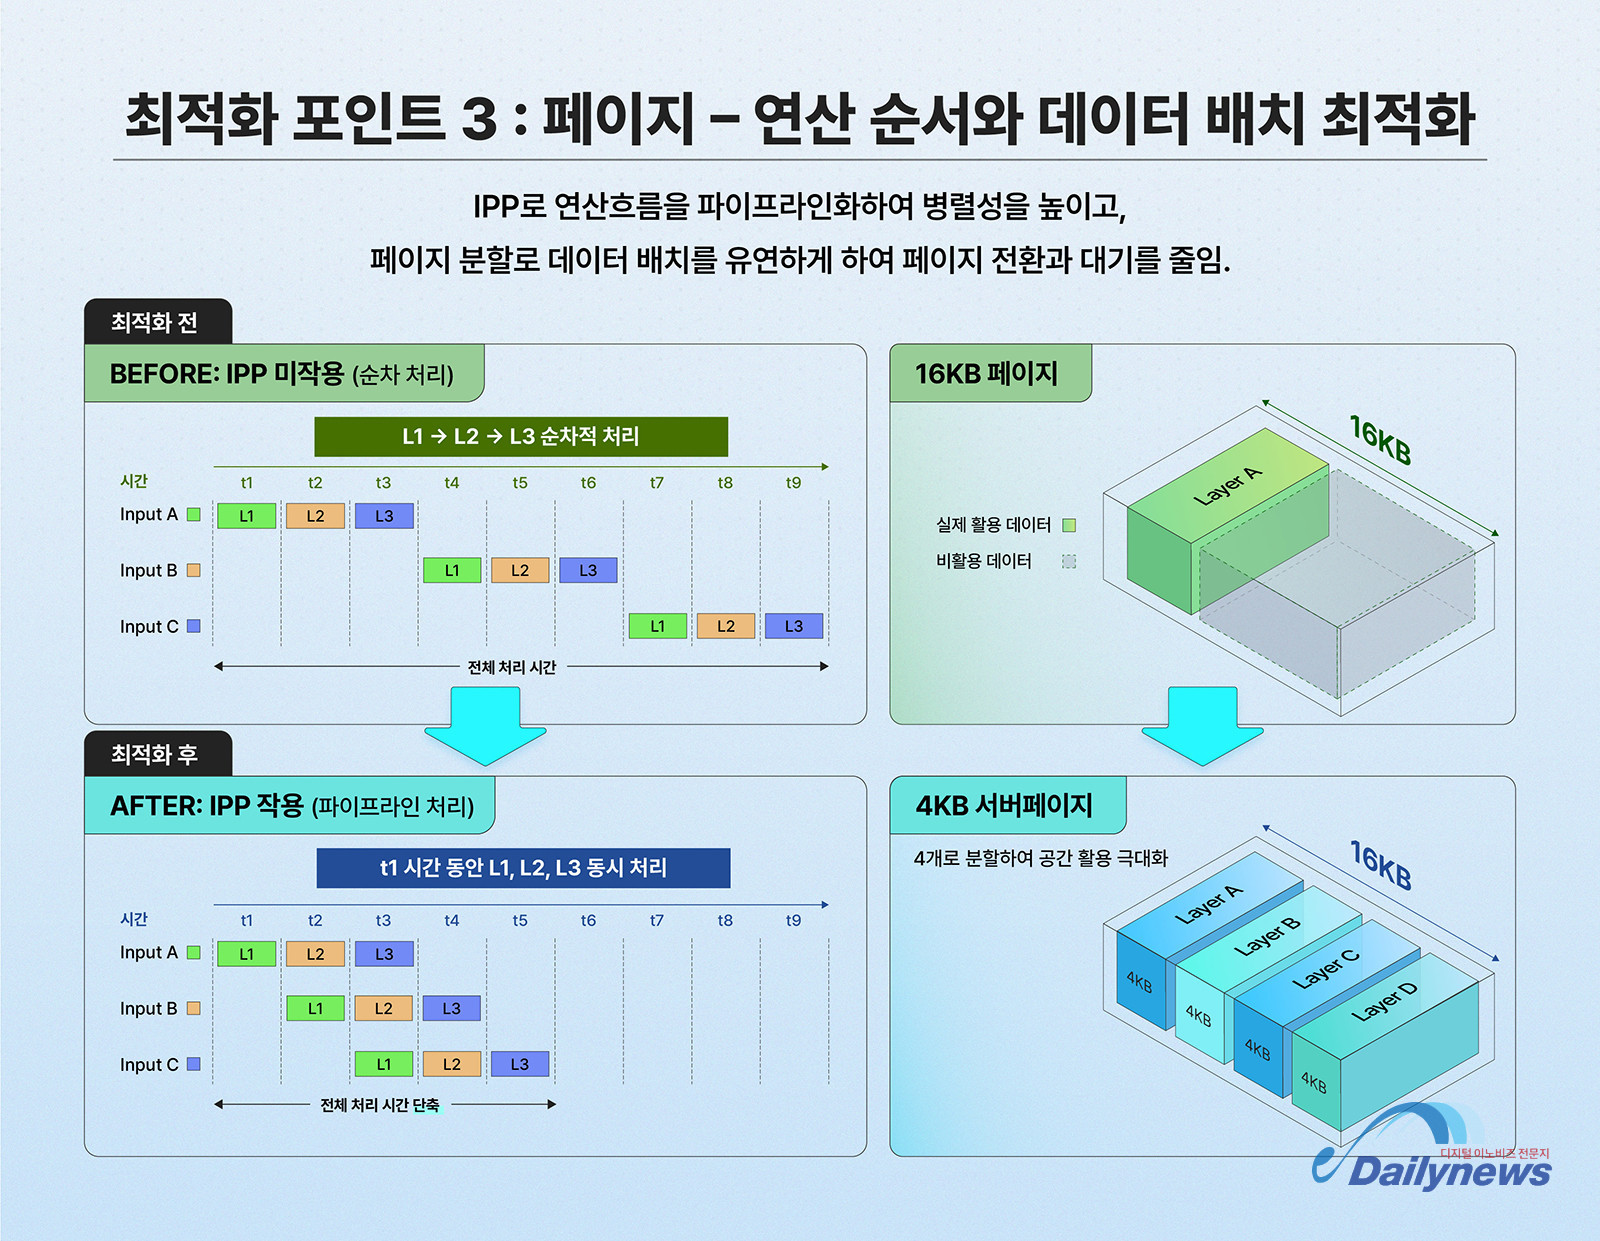
페이지 영역에서는 신경망 구조에 맞춰 데이터를 배치하고 연산 순서를 조정했다. A-CiM의 처리량은 한 페이지나 배열에서 얼마나 많은 입력을 병렬로 처리할 수 있는지에 영향을 받는다. 페이지 사이를 전환하는 횟수 역시 에너지 효율과 지연 시간을 좌우한다.
연구팀은 먼저 하나의 페이지 안에서 신경망 레이어를 효율적으로 구성하는 인페이지 파이프라이닝(IPP)을 적용했다. 신경망 레이어는 입력을 받아 가중치와 연산한 뒤 다음 단계로 전달하는 계산 단위다. IPP는 필요에 따라 레이어를 복제해 병렬성을 높이고, MAC 연산 횟수와 워드라인 전환 횟수를 함께 줄이도록 설계됐다.
시뮬레이션에서 IPP를 적용한 구조는 기준 구조보다 에너지 효율이 2배, 처리량이 9배 높았다. 저장 용량뿐 아니라 페이지 내부에서 데이터를 운용하는 순서와 단위도 연산 성능에 중요한 영향을 준다는 결과다.
또 다른 방식은 기존 16KB 페이지를 네 개의 4KB 서브페이지로 나누는 페이지 분할이다. 작은 단위로 나눈 공간을 신경망 레이어의 입력·출력 크기에 맞춰 활용하고, 남는 서브페이지에는 복제 레이어나 다른 레이어를 배치했다. 이를 통해 작업에 필요한 페이지 수와 페이지 전환에 드는 에너지, 지연 시간을 줄였다.
페이지 분할을 적용했을 때 에너지 효율은 1.2배, 처리량은 1.7배 향상됐다. 다만 페이지를 작게 나눌수록 항상 성능이 좋아지는 것은 아니었다. 페이지가 지나치게 작으면 신경망 레이어가 과도하게 분할돼 MAC 지연이 늘어날 수 있어, 적절한 페이지 크기는 모델에 따라 달라졌다.
높은 집적도와 시스템 설계가 함께 만든 성능 개선
제한된 칩 면적에서 나타난 처리량 약 10~20배, 에너지 효율 약 4,000~5,000배 개선은 기존 2차원 비휘발성 메모리 배열과 비교한 시뮬레이션 결과다. 연구팀은 이 수치에 3D FeNAND의 높은 집적도와 데이터 이동·재기록 감소 효과가 반영됐다고 설명했다.
같은 면적에서 저장할 수 있는 가중치가 제한되는 2차원 배열은 연산 과정에서 데이터를 반복해서 불러와야 한다. 이때 이동과 재기록에 필요한 에너지가 발생한다. 반면 3D FeNAND는 더 많은 가중치를 한 번에 저장하고 연산에 활용할 수 있어 재로딩 부담을 낮춘다.
연구 과정에서는 강유전체 소자, 낸드 구조, AI 작업 특성을 동시에 고려해야 했다. 연구팀은 서로 다른 전문 분야의 연구자들이 각 영역의 최적화 결과를 공유하고 이를 다시 설계에 반영하는 방식으로 공동 최적화를 진행했다.
이번 연구는 낸드의 활용 범위를 데이터 저장에서 연산으로 넓힐 가능성을 제시했다. 셀에서 값을 정밀하게 표현하고, 비셀 구조에서 선택과 전환 부담을 줄이며, 페이지에서 연산 순서와 데이터 배치를 맞추는 통합 설계가 핵심이다. 연구팀은 이러한 접근이 AI 연산뿐 아니라 메모리 내부 검색 등 데이터 중심 연산 분야로도 확장될 수 있다고 설명했다.
댓글
0